移动代理亚马逊数据采集 — 大规模抓取商品
免遭 IP 封禁从亚马逊提取实时价格、标题、评分与库存数据。包含 Python 示例代码、DevTools 审查与不限流 4G/5G 移动代理的入门指南。
- CGNAT IP 信任机制 — 移动运营商 IP 可彻底消除亚马逊自动化机器人标记与人机验证验证码。
- 8 秒极速轮换 API — 一旦触发风控,通过 Webhook 仅需 8 秒即可更换全新的蜂窝公共 IP。
- 无限制带宽 — 畅快抓取图片丰富的亚马逊商品页面,无需按 GB 计费。
- 国家级定位 — 获取本地化价格、购物车 (Buy Box) 赢得者以及真实配送信息。
使用目标国家原生蜂窝 IP 抓取 Amazon.com、Amazon.co.uk 或 Amazon.de。
当亚马逊拦截自动化请求时,通过 API 仅需 8 秒即可轮换新 IP。
抓取亚马逊实时商品数据是现代跨境电商中最具杠杆效应的核心技能之一。面对数以亿计的商品和瞬息万变的价格,获取实时亚马逊数据能够提供竞品监控、价格优化和抢占市场份额所需的透明度。
亚马逊官方 API(例如已弃用的 PA-API 5.0 或创作者 API)要么要求有持续的推广佣金出单配额,要么仅限查看您自己拥有的商品。网页抓取是监控整个公开市场的唯一可靠手段。
本指南将深入剖析抓取亚马逊商品数据的实用价值、商业用途,并通过 DevTools 审查、简洁规范的 Python 代码以及不限流量的移动代理带您逐步上手实战。
1. 为何要采集亚马逊商品数据?(核心商业应用)
抓取亚马逊商品数据让您告别凭空猜测,基于真实的经过验证的市场数据做出决策。电商卖家与开发者依赖此类数据完成以下五大核心业务:
| 用例 | 目标数据维度 | 商业价值赋能 |
|---|---|---|
| 动态调价与黄金购物车 (Buy Box) 追踪 | 当前售价、运费、Buy Box 赢得者 | 自动化调价规则以赢得黄金购物车,同时避免恶性低价竞争蚕食利润空间。 |
| 竞品库存断货预警 | 库存状态 ('有货' / '仅剩 2 件') | 在核心竞品断货时即时察觉,自动提高广告投放预算抢占其流失的流量与销量。 |
| 买家评论情感分析 | 评论正文、星级评分、VP 认证购买标识 | 深度分析真实买家评论,挖掘竞品的普遍缺陷与痛点,从而针对性改良自身产品设计。 |
| 最低转售限价 (MAP) 合规监控 | 分销商售价、第三方店铺名称 | 品牌制造商监督授权零售商是否遵守协议,杜绝违规低价倾销破坏价格体系。 |
| 潜力类目与爆款趋势挖掘 | 热销榜排名 (BSR)、出单增速 | 在同行察觉前数周捕捉快速增长的细分利基市场与新兴消费潮流。 |
2. 逐步实战指南:如何使用 Python 抓取亚马逊商品
我们将构建一个高效整洁的采集器。首先提取商品标题、价格、评分及主图链接,接着实现整个搜索列表页的批量采集。
步骤 1:安装依赖库
您只需安装三个轻量级且常用的 Python 库:
pip install requests beautifulsoup4 pandas步骤 2:规避 503 报错拦截(配置浏览器请求头)
若不携带任何标头发送原生 HTTP 请求,亚马逊会迅速识别出脚本爬虫并直接返回 HTTP 503 Service Unavailable 拦截错误。
为了伪装成真实浏览器,在 Chrome 中按 F12 打开开发者工具,切换到 Network 面板,刷新任意亚马逊页面并点击第一个请求查看请求头 (Request Headers):
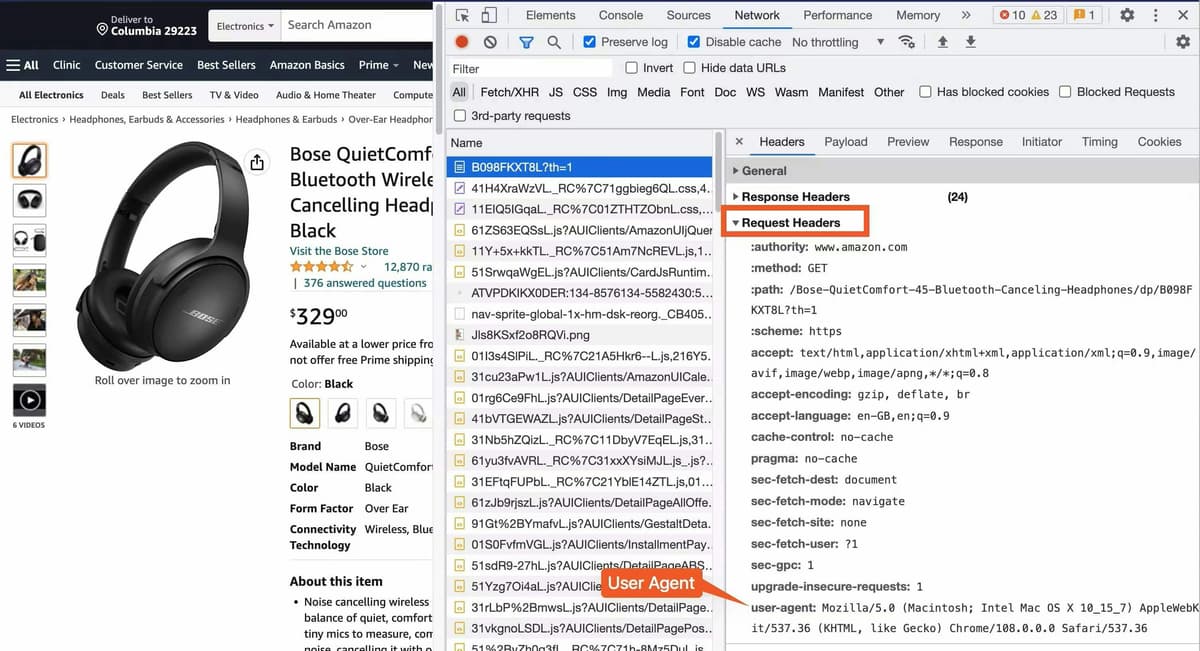
在 Python 字典中配置这些请求标头:
import requests

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36',
    'Accept-Language': 'en-US,en;q=0.9',
    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',
    'Referer': 'https://www.google.com/'
}步骤 3:审查商品详情元素(标题与价格)
在 Chrome 中打开任意亚马逊商品页面,右键点击商品标题并选择“检查”:
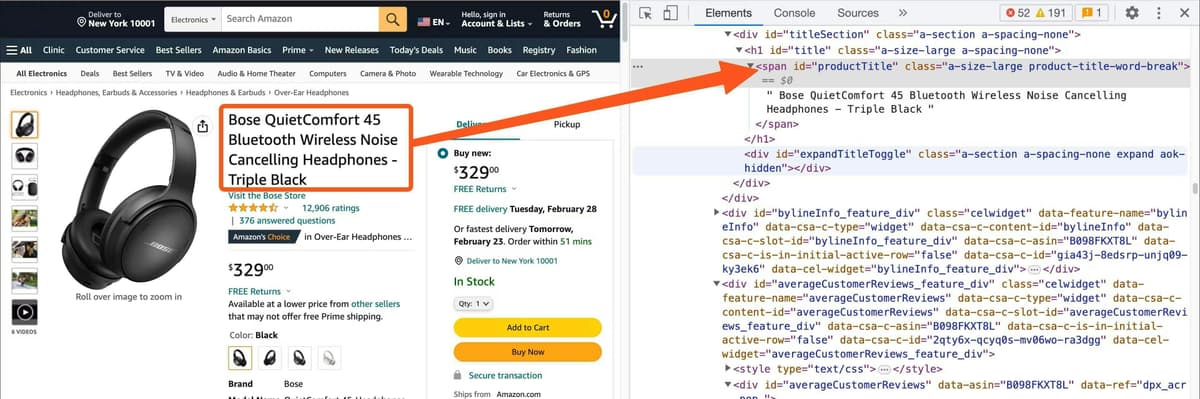
商品标题包含在带有唯一 ID #productTitle 的元素中。
接着,右键点击价格并选择“检查”:
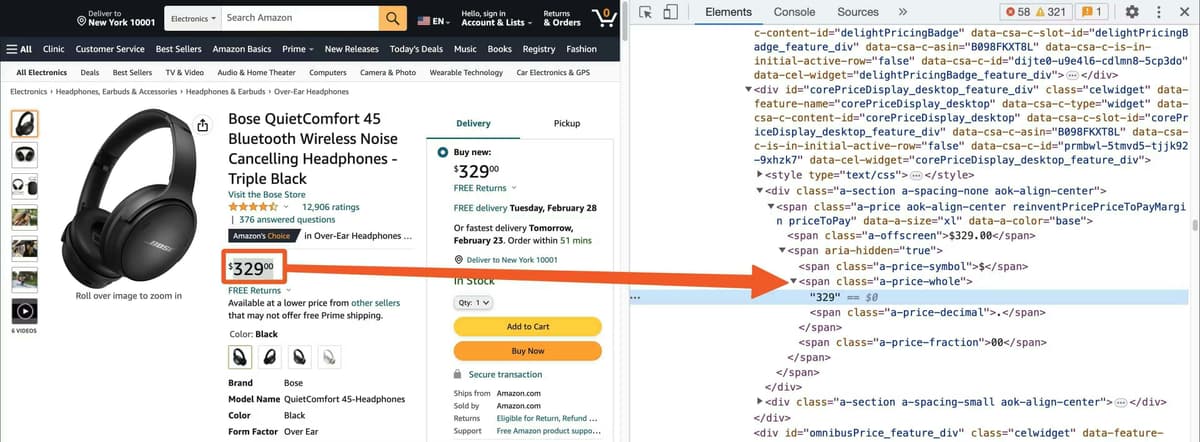
步骤 4:Python 完整提取脚本
以下是提取任意亚马逊商品核心字段的标准 Python 脚本:
import requests
from bs4 import BeautifulSoup

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36',
    'Accept-Language': 'en-US,en;q=0.9',
    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
}

def scrape_amazon_product(url):
    response = requests.get(url, headers=headers, timeout=15)

    if response.status_code != 200:
        print(f"Failed to fetch page. Status code: {response.status_code}")
        return None

    soup = BeautifulSoup(response.text, 'html.parser')

    # 1. Product Title
    title_el = soup.select_one('#productTitle')
    title = title_el.text.strip() if title_el else "N/A"

    # 2. Product Price
    price_el = soup.select_one('.a-price .a-offscreen')
    price = price_el.text.strip() if price_el else "N/A"

    # 3. Rating
    rating_el = soup.select_one('#acrPopover')
    rating = rating_el.get('title') if rating_el else "N/A"

    # 4. Main Product Image
    img_el = soup.select_one('#landingImage')
    image_url = img_el.get('src') if img_el else "N/A"

    return {
        "title": title,
        "price": price,
        "rating": rating,
        "image_url": image_url
    }

# Test with a sample product URL
product = scrape_amazon_product("https://www.amazon.com/dp/B0C3HCD34R")
print(product)采集生成的结构化数据:
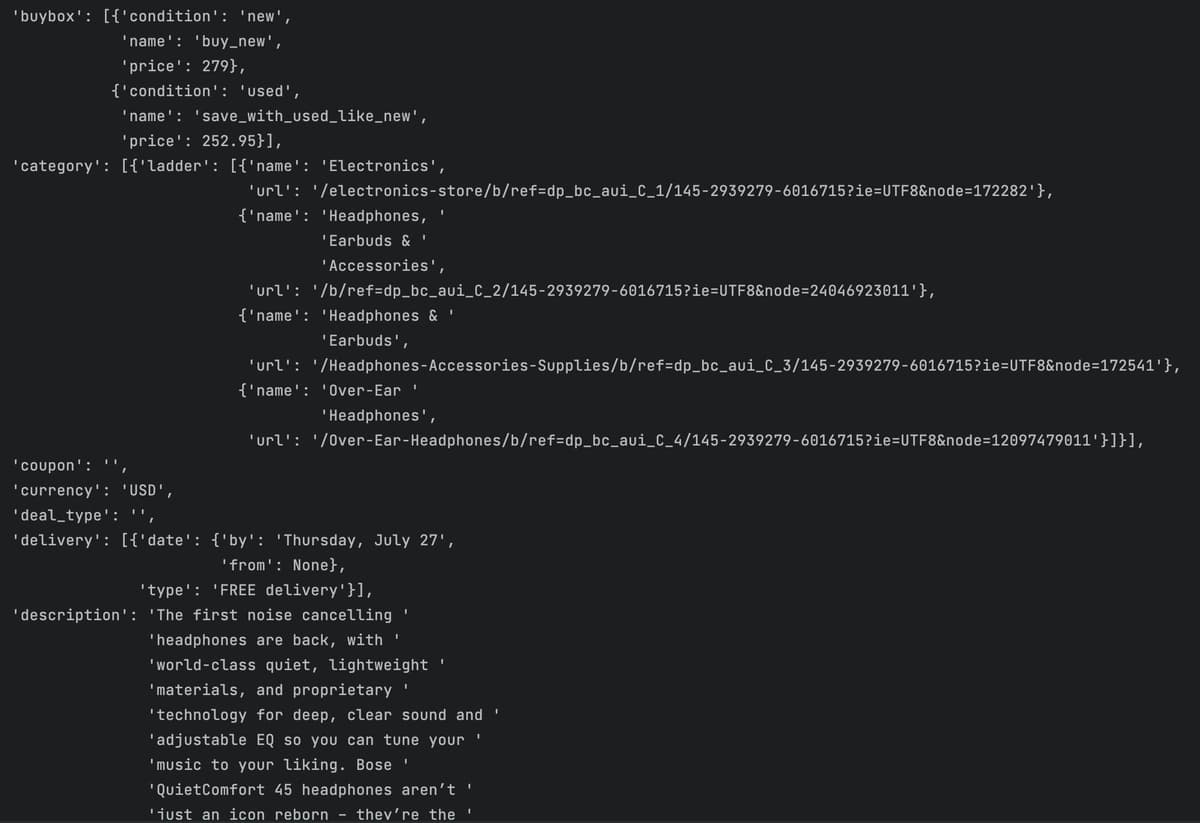
步骤 5:批量抓取搜索列表页商品
To scrape an entire category or keyword search, target the search result cards. Each organic product card is wrapped inside div[data-component-type="s-search-result"]:
import requests
from bs4 import BeautifulSoup
import pandas as pd

def scrape_search_results(keyword):
    search_url = f"https://www.amazon.com/s?k={keyword}"
    response = requests.get(search_url, headers=headers)
    soup = BeautifulSoup(response.text, 'html.parser')

    items = []
    for card in soup.select('div[data-component-type="s-search-result"]'):
        asin = card.get('data-asin')
        title_el = card.select_one('h2 a span') or card.select_one('h2')
        price_el = card.select_one('.a-price .a-offscreen')

        if asin and title_el:
            items.append({
                "asin": asin,
                "title": title_el.text.strip(),
                "price": price_el.text.strip() if price_el else "N/A"
            })

    df = pd.DataFrame(items)
    df.to_csv("amazon_search_results.csv", index=False)
    print(f"[+] Saved {len(items)} products to amazon_search_results.csv")
    return items

scrape_search_results("over ear headphones")3. 规模化采集瓶颈:为何简易脚本很快失效
在本地电脑上抓取 10 到 20 个商品时该脚本运转良好。但一旦尝试批量采集成百上千个页面,就会遭遇亚马逊森严的反爬风控防御:
-
人机验证图形码封锁
在单个 IP 发送 30–50 个请求后,亚马逊将停止返回商品页面,并强制弹出:'Type the characters you see in this image' 人机验证码。
-
数据中心机房代理在首个请求即被拦截
AWS WAF 会立即识别出廉价的数据中心云服务器 IP(AWS、DigitalOcean、Hetzner 等)。整个托管机房网段在 HTML 渲染前就会被直接掐断。
-
按流量计费的住宅代理成本难以承受
亚马逊商品详情页极为庞大(单页 2 MB 至 4 MB)。抓取 50,000 个商品需消耗 150 GB 以上的流量。按住宅代理每 GB 4 至 8 美元的价格计算,单次采集任务仅代理账单就高达 600 到 1200 美元。
4. 解决方案:4G/5G 移动代理与即时 IP 轮换
业界应对亚马逊大规模抓取的标准方案是通过独享 4G/5G 移动代理转发请求:
- 运营商级 NAT (CGNAT) 免封禁免疫 — 移动运营商让数千名真实手机用户共享同一个公网 IPv4 出口地址。亚马逊无法封禁移动 IP,否则会导致大量使用手机 App 的真实买家无法正常购物。
- 通过 API 实现秒级 IP 轮换 — 当亚马逊返回反爬阻碍时,自动向 PXM2 轮换 Webhook 发送一次 GET 请求。您的蜂窝调制解调器将在 8 秒内获得全新公网 IP,脚本随即恢复正常抓取。
- 不限流量固定月费 — PXM2 独享 4G/5G 移动代理包含无限数据流量 — 彻底告别按流量计费的账单惊吓。
在 Python 脚本中集成轮换移动代理
import requests
import time

# 1. PXM2 Mobile Proxy Credentials
PROXIES = {
    "http": "http://username:password@proxy.pxm2.io:1080",
    "https": "http://username:password@proxy.pxm2.io:1080",
}

# 2. PXM2 Instant IP Rotation API Webhook
ROTATION_URL = "https://api.pxm2.io/v1/rotate?key=YOUR_API_KEY"

def rotate_mobile_ip():
    """Cycle the cellular carrier IP when Amazon serves a CAPTCHA or 503."""
    print("[*] Bot block detected. Triggering mobile IP change...")
    requests.get(ROTATION_URL, timeout=10)
    time.sleep(8)  # Allow modem to renegotiate radio connection
    print("[+] Fresh cellular IP acquired!")

def fetch_product_safe(url):
    session = requests.Session()
    session.proxies = PROXIES
    session.headers.update(headers)

    for attempt in range(3):
        res = session.get(url, timeout=15)

        # Check for CAPTCHA or rate limits
        if res.status_code == 503 or "Robot Check" in res.text:
            rotate_mobile_ip()
            continue

        if res.status_code == 200:
            return res.text

return None获取用于亚马逊抓取的移动代理
PXM2 在线机房 — 选择您要采集的亚马逊站点所在国家,获取不限流量与轮换次数的独享 4G/5G IP:
法国
新加坡
印度
常见问题解答
在亚马逊上抓取商品数据合法吗?
合法。在美国和欧盟,提取公开可访问的商品数据(标题、价格、评分、库存状态)属于合法行为(如 hiQ Labs 诉 LinkedIn 判例)。爬虫必须在免登录状态下访问公开页面,避开版权图片或个人可识别信息 (PII),并保持友好的请求频率。
抓取亚马逊用 VPN 好还是代理好?
独享轮换移动代理远胜于 VPN。VPN 将整台设备的所有流量路由至单个静态 IP,无法通过代码动态轮换。而移动代理支持脚本级鉴权、多线程流水线以及通过 Webhook 进行自动化 IP 轮换。
如何绕过亚马逊“请输入图中字符”的图形验证码?
切勿浪费时间对接第三方打码平台。破解亚马逊验证码需要 15 秒以上且极易反复弹出。行业标准做法是事件驱动型 IP 轮换:当爬虫检测到 503 或验证码页面时,调用 PXM2 轮换 Webhook,8 秒内获取全新的蜂窝 IP 并立即恢复抓取。
为什么搜索结果卡片中有时价格缺失?
亚马逊会根据 IP 地理位置定制服务端渲染的 HTML。从非美国地区访问 Amazon.com 会隐藏无法进行国际配送的商品价格。请使用匹配该站点的美国移动代理,或在请求中携带美国邮编 Cookie。
抓取亚马逊商品需要使用 Playwright 或 Selenium 吗?
提取核心商品信息并不需要。标题、价格、星级和库存信息均包含在服务端初始返回的 HTML 中。Python requests 和 BeautifulSoup 的运行速度比无头浏览器快 10 倍,且内存消耗低 90%。只有在需要点击动态规格变体或交互组件时才需使用 Playwright。
在移动代理上每分钟可以发送多少个请求?
单个独享 4G/5G 设备在加入 1 到 2 秒随机延迟的情况下,每分钟可稳定处理 20–30 个请求。如需更高吞吐量,可利用 PXM2 的多设备集群进行负载分发。
相关移动代理指南
探索 PXM2 数据采集与浏览器自动化集群中的更多技术指南: