Скрапинг Amazon через мобильные прокси — масштабный сбор данных
Собирайте актуальные цены, названия, рейтинги и остатки на складе Amazon без блокировок. Пошаговое руководство с кодом Python, инспекцией DevTools и безлимитными мобильными прокси 4G/5G.
- Доверие CGNAT IP — мобильные IP операторов исключают детекты ботов и капчи проверки Amazon.
- API ротации за 8 секунд — мгновенная смена публичного мобильного IP через вебхук при обнаружении.
- Безлимитный трафик — собирайте тяжелые страницы товаров Amazon без платы за каждый гигабайт.
- Таргетинг по странам — просматривайте локализованные цены, победителей Buy Box и условия доставки.
Парсите Amazon.com, Amazon.co.uk или Amazon.de с нативными мобильными IP целевой страны.
Меняйте IP за 8 секунд через API при запросах капчи со стороны Amazon.
Извлечение актуальных данных о товарах на Amazon — один из самых эффективных навыков в современной электронной коммерции. Имея дело с сотнями миллионов товаров и непрерывно меняющимися ценами, доступ к живым данным дает прозрачность в реальном времени для анализа конкурентов, оптимизации цен и захвата доли рынка.
Официальные API Amazon (такие как устаревший PA-API 5.0 или Creator API) либо требуют активных квот партнерских продаж, либо ограничивают доступ только вашими собственными товарами. Веб-скрапинг — единственный надежный способ мониторинга всего открытого маркетплейса.
В этом руководстве объясняется, почему полезен парсинг товаров на Amazon, для каких бизнес-задач нужны эти данные и как шаг за шагом настроить сбор с помощью DevTools, чистого кода Python и безлимитных мобильных прокси.
1. Зачем парсить товары на Amazon? (И для чего это используется)
Парсинг товаров на Amazon заменяет догадки проверенными фактами с рынка. Бизнес в сфере e-commerce и разработчики используют эти данные для пяти основных направлений:
| Вариант использования | Целевые данные | Влияние на бизнес |
|---|---|---|
| Динамическое ценообразование и отслеживание Buy Box | Текущая цена, доставка, победитель Buy Box | Автоматизируйте правила репрайсинга, чтобы выигрывать Buy Box без демпинга и потери маржи. |
| Оповещения об остатках конкурентов | Статус наличия ('In Stock' / 'Осталось 2') | Отслеживайте, когда у ключевых конкурентов заканчиваются запасы, и автоматически увеличивайте расходы на рекламу для перехвата продаж. |
| Анализ тональности отзывов | Текст отзыва, рейтинг, подтвержденная покупка | Анализируйте отзывы покупателей для выявления повторяющихся дефектов в товарах конкурентов и улучшения своего продукта. |
| Мониторинг соблюдения цен (MAP) | Цена реселлера, имя стороннего продавца | Производители брендов проверяют, что авторизованные ритейлеры не занижают контрактные минимальные розничные цены. |
| Поиск ниш и новых трендов | Рейтинг бестселлеров (BSR), скорость продаж | Находите быстрорастущие ниши и выявляйте новые потребительские тренды на недели раньше конкурентов. |
2. Пошаговое руководство: как парсить товары на Amazon на Python
Давайте создадим чистый рабочий скрапер. Мы извлечем название товара, цену, рейтинг и URL изображения, а затем спарсим целые страницы поисковой выдачи.
Шаг 1: Установка необходимых библиотек
Вам понадобятся всего три стандартные легковесные библиотеки Python:
pip install requests beautifulsoup4 pandasШаг 2: Предотвращение мгновенной блокировки 503 (добавление заголовков браузера)
Если отправить базовый HTTP-запрос без заголовков, Amazon определит бота и мгновенно вернет ошибку HTTP 503 Service Unavailable.
Чтобы выглядеть как настоящий браузер, нажмите F12 в Google Chrome, перейдите во вкладку Network, обновите любую страницу Amazon и выберите первый запрос для просмотра заголовков (Request Headers):
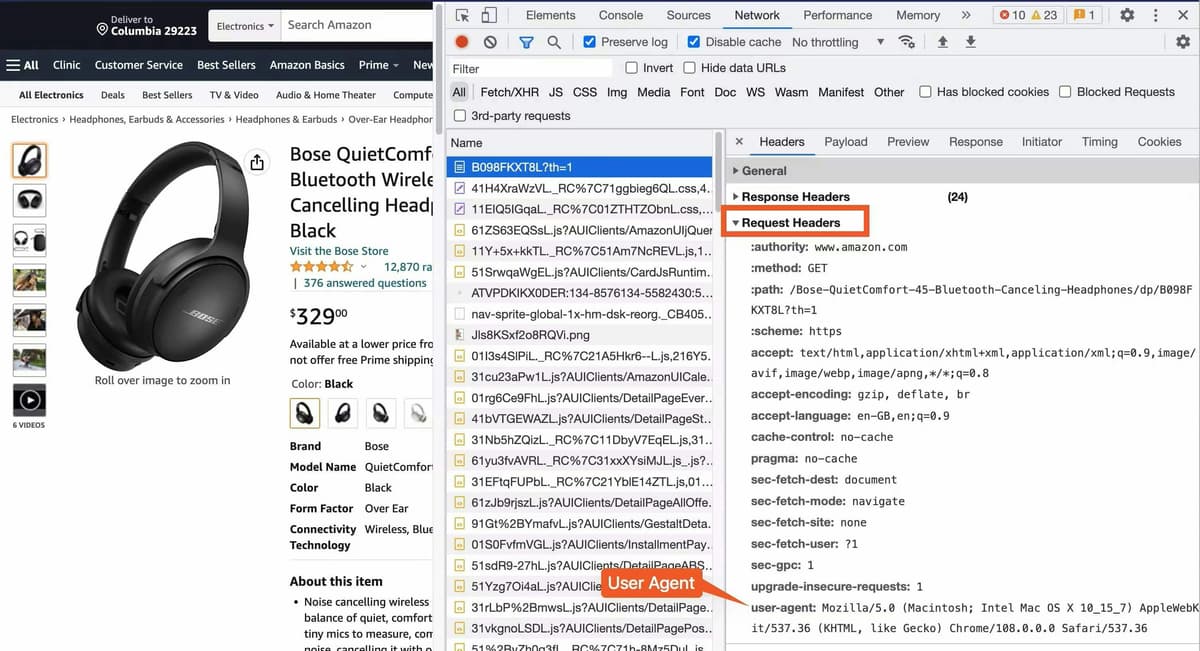
В Python добавьте эти заголовки в словарь запроса:
import requests

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36',
    'Accept-Language': 'en-US,en;q=0.9',
    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',
    'Referer': 'https://www.google.com/'
}Шаг 3: Инспекция деталей товара (название и цена)
Откройте любую страницу товара Amazon в Chrome, кликните правой кнопкой мыши по названию товара и выберите "Просмотреть код":
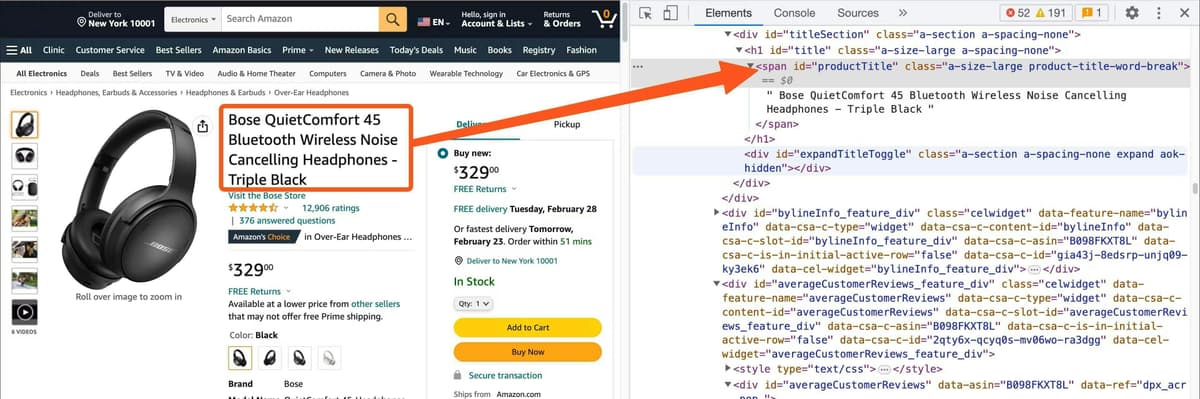
Название обернуто в элемент с уникальным ID #productTitle.
Затем кликните правой кнопкой мыши по цене и выберите "Просмотреть код":
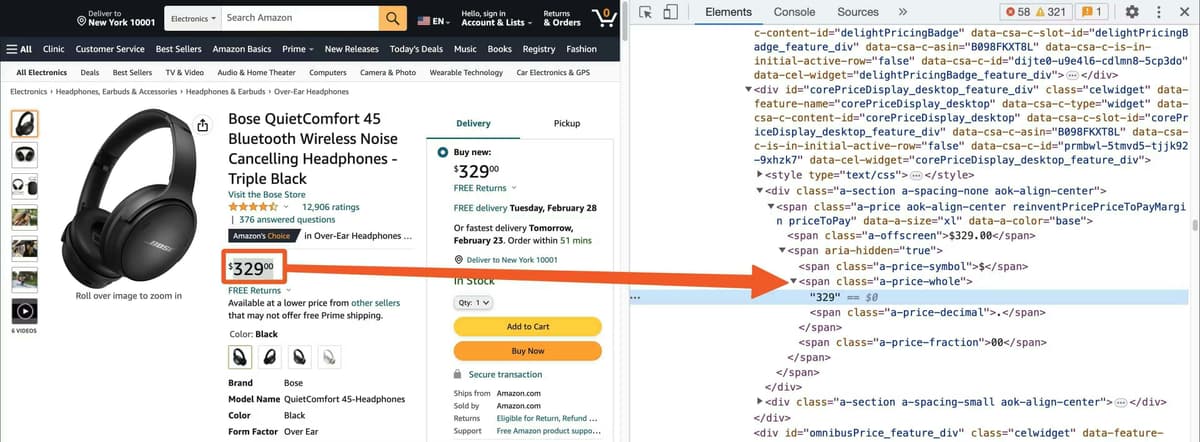
Шаг 4: Python-скрипт извлечения данных
Вот готовый скрипт, извлекающий основные атрибуты любого товара на Amazon:
import requests
from bs4 import BeautifulSoup

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36',
    'Accept-Language': 'en-US,en;q=0.9',
    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
}

def scrape_amazon_product(url):
    response = requests.get(url, headers=headers, timeout=15)

    if response.status_code != 200:
        print(f"Failed to fetch page. Status code: {response.status_code}")
        return None

    soup = BeautifulSoup(response.text, 'html.parser')

    # 1. Product Title
    title_el = soup.select_one('#productTitle')
    title = title_el.text.strip() if title_el else "N/A"

    # 2. Product Price
    price_el = soup.select_one('.a-price .a-offscreen')
    price = price_el.text.strip() if price_el else "N/A"

    # 3. Rating
    rating_el = soup.select_one('#acrPopover')
    rating = rating_el.get('title') if rating_el else "N/A"

    # 4. Main Product Image
    img_el = soup.select_one('#landingImage')
    image_url = img_el.get('src') if img_el else "N/A"

    return {
        "title": title,
        "price": price,
        "rating": rating,
        "image_url": image_url
    }

# Test with a sample product URL
product = scrape_amazon_product("https://www.amazon.com/dp/B0C3HCD34R")
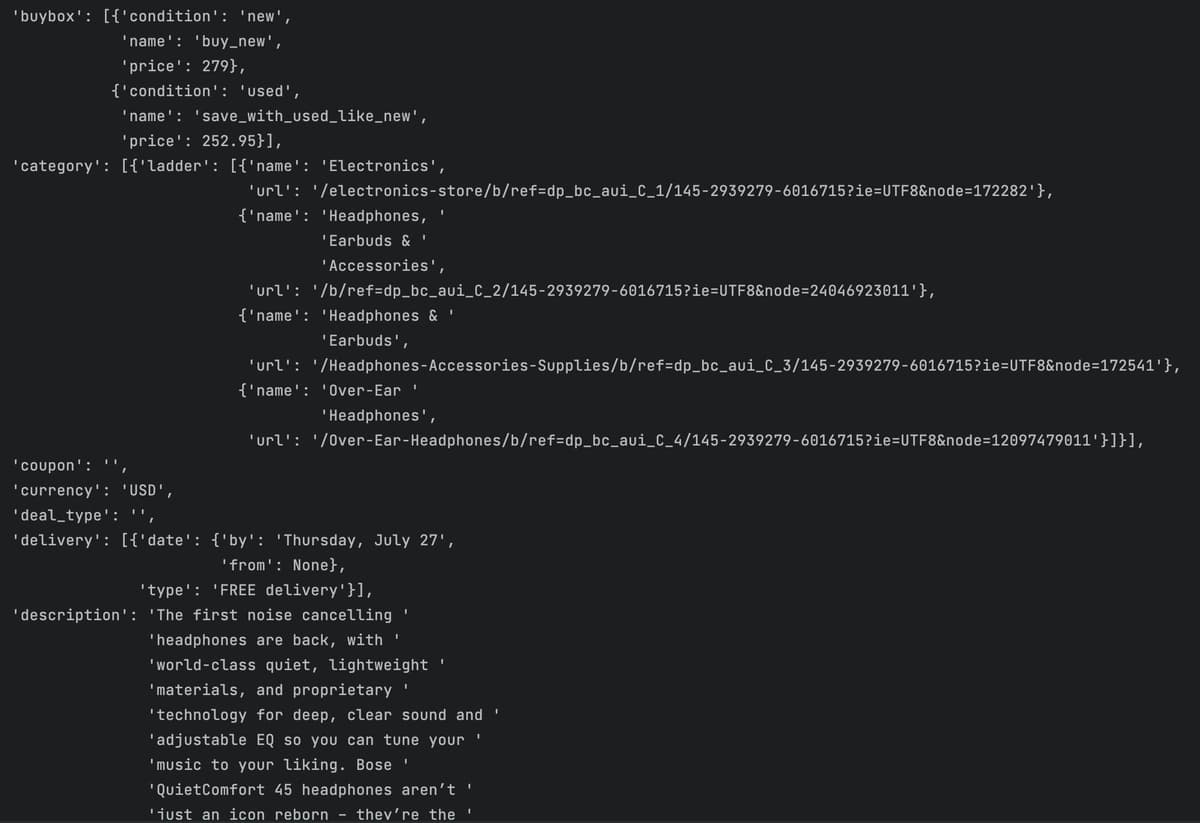
print(product)Извлеченные структурированные данные:
Шаг 5: Парсинг страниц поисковой выдачи и множества товаров
To scrape an entire category or keyword search, target the search result cards. Each organic product card is wrapped inside div[data-component-type="s-search-result"]:
import requests
from bs4 import BeautifulSoup
import pandas as pd

def scrape_search_results(keyword):
    search_url = f"https://www.amazon.com/s?k={keyword}"
    response = requests.get(search_url, headers=headers)
    soup = BeautifulSoup(response.text, 'html.parser')

    items = []
    for card in soup.select('div[data-component-type="s-search-result"]'):
        asin = card.get('data-asin')
        title_el = card.select_one('h2 a span') or card.select_one('h2')
        price_el = card.select_one('.a-price .a-offscreen')

        if asin and title_el:
            items.append({
                "asin": asin,
                "title": title_el.text.strip(),
                "price": price_el.text.strip() if price_el else "N/A"
            })

    df = pd.DataFrame(items)
    df.to_csv("amazon_search_results.csv", index=False)
    print(f"[+] Saved {len(items)} products to amazon_search_results.csv")
    return items

scrape_search_results("over ear headphones")3. Проблема масштабирования: почему простые скрипты перестают работать
Базовый скрипт отлично работает для 10–20 товаров с локального компьютера. Но при попытке собрать сотни или тысячи страниц вы сталкиваетесь с антифрод-защитой Amazon:
-
Стена капчи проверки робота
После 30–50 запросов с одного IP Amazon перестает отдавать страницы товаров и возвращает: 'Type the characters you see in this image'.
-
Дата-центр прокси блокируются с первого запроса
Дешевые серверные IP дата-центров (AWS, DigitalOcean, Hetzner) моментально определяются AWS WAF. Целые подсети хостинга блокируются до рендера HTML.
-
Резидентные прокси с оплатой за ГБ сжигают бюджет
Страницы товаров Amazon весят много (от 2 до 4 МБ). Сбор 50 000 товаров расходует более 150 ГБ трафика. При тарифах $4–$8 за ГБ на резидентных прокси один запуск обойдется в $600–$1200.
4. Решение: мобильные прокси 4G/5G и мгновенная ротация IP
Отраслевой стандарт крупномасштабного скрапинга Amazon — маршрутизация запросов через выделенные мобильные прокси 4G/5G:
- Иммунитет благодаря операторскому CGNAT — Мобильные операторы распределяют один публичный выходной IPv4 среди тысяч реальных пользователей смартфонов. Amazon не может заблокировать мобильный IP, не отрезав от сервиса тысячи реальных покупателей в приложении.
- Мгновенная ротация IP через API — Если Amazon выдает проверку антибота, отправьте автоматический GET-запрос на вебхук ротации PXM2. Модем переподключается с новым публичным IP за 8 секунд, и скрипт сразу продолжает сбор.
- Безлимитный трафик по фиксированной цене — Мобильные прокси PXM2 включают безлимитный трафик на выделенных модемах 4G/5G — никаких непредвиденных счетов за гигабайты.
Подключение ротационных мобильных прокси к Python-скрипту
import requests
import time

# 1. PXM2 Mobile Proxy Credentials
PROXIES = {
    "http": "http://username:password@proxy.pxm2.io:1080",
    "https": "http://username:password@proxy.pxm2.io:1080",
}

# 2. PXM2 Instant IP Rotation API Webhook
ROTATION_URL = "https://api.pxm2.io/v1/rotate?key=YOUR_API_KEY"

def rotate_mobile_ip():
    """Cycle the cellular carrier IP when Amazon serves a CAPTCHA or 503."""
    print("[*] Bot block detected. Triggering mobile IP change...")
    requests.get(ROTATION_URL, timeout=10)
    time.sleep(8)  # Allow modem to renegotiate radio connection
    print("[+] Fresh cellular IP acquired!")

def fetch_product_safe(url):
    session = requests.Session()
    session.proxies = PROXIES
    session.headers.update(headers)

    for attempt in range(3):
        res = session.get(url, timeout=15)

        # Check for CAPTCHA or rate limits
        if res.status_code == 503 or "Robot Check" in res.text:
            rotate_mobile_ip()
            continue

        if res.status_code == 200:
            return res.text

return NoneПолучить мобильный прокси для парсинга Amazon
Доступные локации PXM2 — выберите страну нужного маркетплейса Amazon и получите выделенный IP 4G/5G с безлимитным трафиком и ротациями:
Великобритания
Испания
Индия
Часто задаваемые вопросы
Законен ли скрапинг товаров на Amazon?
Да. Извлечение общедоступных данных о товарах (названия, цены, рейтинги, наличие) законно в США и ЕС, что подтверждено решениями судов (hiQ Labs v. LinkedIn). Скраперы должны обращаться к публичным витринам без авторизации, избегать защищенных копирайтом изображений и персональных данных (PII), а также соблюдать разумные интервалы запросов.
Что лучше для скрапинга Amazon: VPN или прокси?
Выделенный ротационный мобильный прокси значительно лучше. VPN направляет весь трафик устройства через один статический IP и не поддается программной ротации. Мобильные прокси поддерживают авторизацию на уровне скрипта, многопоточные пайплайны и автоматическую смену IP по вебхуку.
Как обойти капчу Amazon "Введите символы, которые вы видите на картинке"?
Не тратьте время на сторонние сервисы распознавания капчи. Решение капчи Amazon занимает 15+ секунд и часто запрашивается снова. Отраслевой стандарт — событийно-управляемая ротация IP: при обнаружении 503 или капчи скрипт вызывает вебхук ротации PXM2, получает чистый мобильный IP за 8 секунд и продолжает работу.
Почему в карточках поиска иногда отсутствуют цены?
Amazon адаптирует серверный HTML под геолокацию IP. При просмотре Amazon.com не из США цены на товары без международной доставки скрываются. Используйте мобильный прокси США, соответствующий маркетплейсу, или передавайте cookie почтового индекса США.
Нужен ли Playwright или Selenium для парсинга товаров Amazon?
Не для основных данных товаров. Названия, цены, рейтинги и наличие передаются в исходном HTML с сервера. Python requests и BeautifulSoup работают в 10 раз быстрее и потребляют на 90% меньше памяти, чем браузеры. Playwright нужен только для кликов по вариантам товара или интерактивных элементов.
Сколько запросов в минуту можно отправлять через мобильный прокси?
Один выделенный модем 4G/5G обрабатывает 20–30 запросов в минуту со случайной задержкой в 1–2 секунды. Для большей пропускной способности распределяйте запросы по массиву модемов PXM2.
Связанные руководства по мобильным прокси-серверам
Ознакомьтесь с другими техническими руководствами PXM2 по скрапингу и автоматизации браузеров:
Скрапинг товаров Amazon без банов IP
Выделенные модемы 4G/5G с нативными IP операторов, ротацией за 8 секунд через вебхук и безлимитным трафиком для тяжелых каталогов товаров.
Начать скрапинг Amazon через мобильные прокси →